4 Estadística de muestreo, inferencia bayesiana y la distribución de Haar
Cada número que entrega un procesador cuántico es una estimación hecha con un número finito de disparos. Este capítulo reúne las herramientas estadísticas de la unidad qg: cómo se propaga el ruido de disparo, qué distribución previa es la natural para un qubit desconocido, cómo construir intervalos que no colapsan cerca de los polos, cómo corregir los sesgos de las cantidades cuadráticas y cuántos disparos hace falta planificar. Todas se apoyan en la base del capítulo 1: lo que se estima es siempre la probabilidad \(p_0\), y como el mili-qang es lineal en ella, cada intervalo y cada plan de disparos se expresa directamente en m-qg. Cierra con el fundamento matemático que explica por qué \(qg_Z\) es la lectura canónica.
4.1 Propagación del ruido de disparo
Con \(N\) disparos y \(k_0\) resultados 0, el estimador natural es \(\widehat{qg}_Z=2k_0/N-1\). Es insesgado y su varianza es exactamente
\[ \operatorname{Var}(\widehat{qg}_Z)=\frac{1-qg_Z^2}{N}=\frac{\sin^2\theta}{N}, \]
que alcanza la cota de Cramér–Rao del parámetro \(qg_Z\): no hay estimador insesgado mejor con la misma información. En mili-qang es la resolución \(\sigma_m=1000\sqrt{1-qg_Z^2}/\sqrt N\) del capítulo 1 (Figura 1.3). Propagada al ángulo por el método delta, la varianza se vuelve constante, \(\operatorname{Var}(\hat\theta)\approx1/N\), como se vio en el capítulo 1 (§5). Las dos afirmaciones son compatibles: \(qg_Z\) es la coordenada curva, con información de Fisher \(1/(1-qg_Z^2)\) por disparo, y \(\theta\) la coordenada plana, con información 1 (capítulo 23).
El método delta es una aproximación de primer orden y falla donde la derivada se anula. Cerca de un polo, \(\widehat{qg}_Z\) vale exactamente \(\pm1\) en una fracción apreciable de los experimentos, y el error estándar estimado \(\sqrt{(1-\widehat{qg}_Z^2)/N}\) se vuelve cero: el intervalo colapsa justo donde el estado es más extremo.
4.1.1 La fase azimutal
La fase se estima con las dos bases transversales, \(\hat\varphi=\operatorname{atan2}(\widehat{qg}_Y,\widehat{qg}_X)\) (Sección 1.4). Con \(N\) disparos en cada base, el método delta da
\[ \operatorname{Var}(\hat\varphi)\approx\frac{1-\tfrac12\sin^2\theta\,\sin^2 2\varphi}{N\sin^2\theta} \;\le\;\frac{1}{N\sin^2\theta}. \]
La cota de la derecha, que es la que usa la versión de trabajo del autor, es exacta sobre los ejes (\(\varphi\) múltiplo de \(90^\circ\)) y cerca de los polos, pero en el ecuador a \(\varphi=45^\circ\) duplica la varianza real. Lo esencial no cambia: la fase se vuelve inobservable al acercarse a un polo, donde \(\sin\theta\to0\). En la escala angular del capítulo 1, en el ecuador y sobre un eje, la desviación es \(159{,}15/\sqrt N\) qga, igual que la del ángulo polar. La lectura transversal \(\widehat{qg}_X=\sin\theta\cos\varphi\), en cambio, no diverge: su varianza es \((1-qg_X^2)/N\le1/N\), por la misma razón que la de \(\widehat{qg}_Z\).
4.2 La distribución de Haar en espacio qg
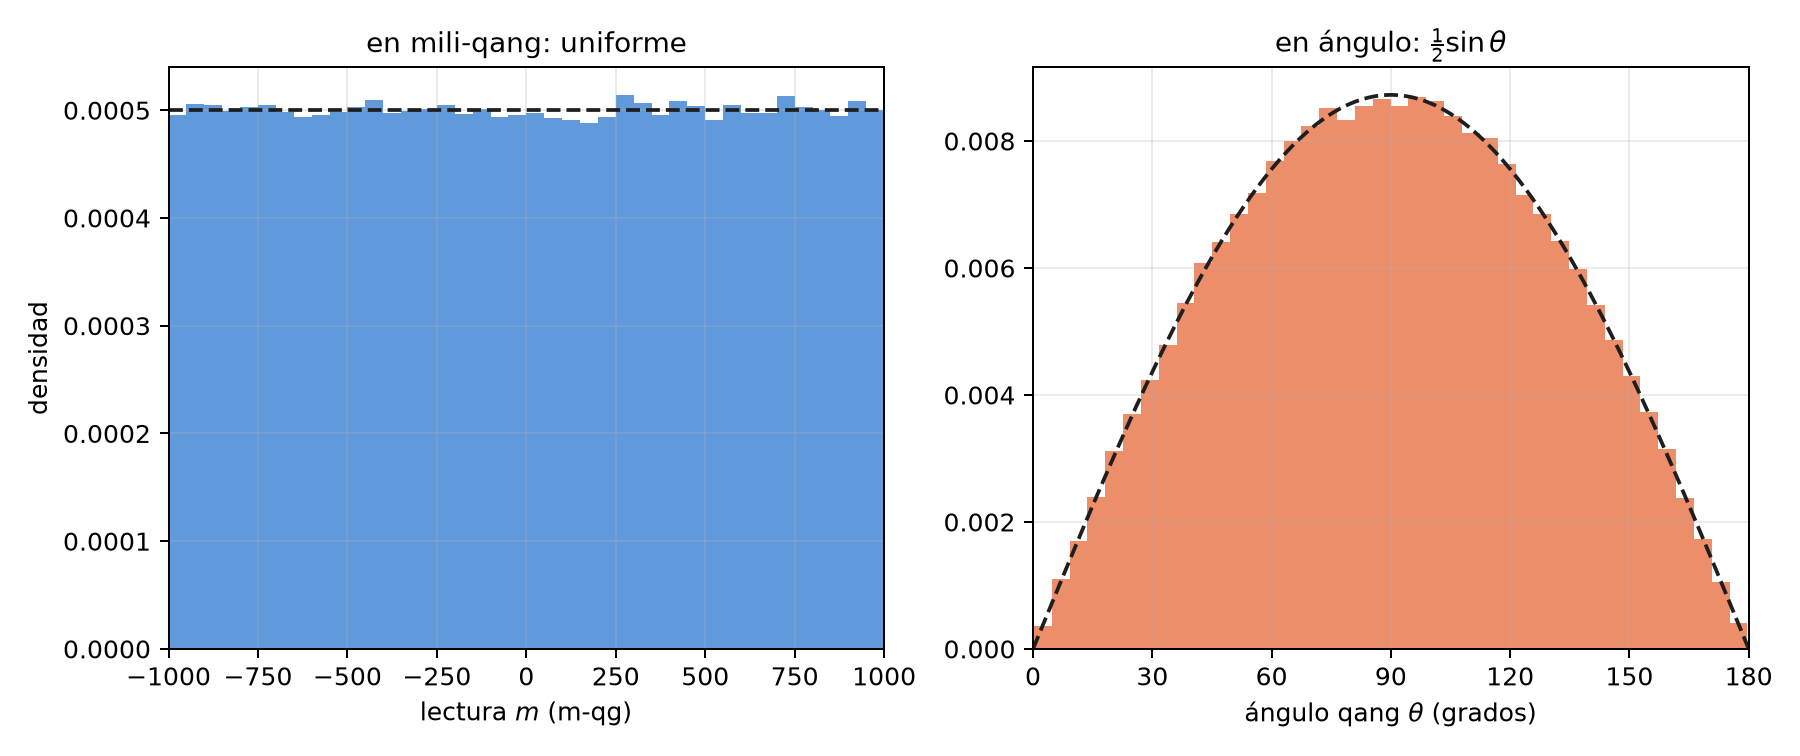
¿Qué se sabe de un qubit antes de medirlo? Si su estado es “cualquiera”, la distribución natural es la medida de Haar, la única invariante ante rotaciones. En unidades qg tiene una forma notable: \(qg_Z\) es uniforme en \([-1,1]\). Es el teorema de la caja de sombrero de Arquímedes: el área de una franja de la esfera entre dos latitudes es proporcional a la diferencia de alturas, no de ángulos. Se comprobó con 200 000 estados de Haar (§15).
La consecuencia estadística es directa. Una previa uniforme en \(qg_Z\) equivale a \(p_0\sim\mathrm{Beta}(1,1)\), y con \(k_0\) ceros en \(N\) disparos la posterior es
\[ p_0\mid k_0\ \sim\ \mathrm{Beta}(k_0+1,\ N-k_0+1), \]
de la que se obtiene un intervalo de credibilidad para \(qg_Z=2p_0-1\) con solo una función beta (bayes_qg_estimate, implementada sin dependencias externas y verificada contra scipy.stats.beta).
La ecuación de probabilidad del capítulo 1 explica por qué esta previa es tan simple. Como \(m=2000\,p_0-1000\) es lineal, una distribución uniforme en \(qg_Z\) es uniforme en mili-qang y uniforme en \(p_0\): los tres enunciados son el mismo. En el ángulo, en cambio, la misma medida tiene densidad \(\tfrac12\sin\theta\) y se concentra en el ecuador (Figura 4.1). La previa “no informativa” depende de la escala en la que se la escribe, y la de Haar es plana exactamente en la escala en la que se mide.
4.3 Intervalos exactos cerca de los polos
La comparación con 50 disparos muestra dónde importa la elección del intervalo (§15):
| caso | método delta | Wilson | Bayes–Haar |
|---|---|---|---|
| cerca de un polo (\(\theta=0{,}08\)): cobertura del intervalo de 95% | 7,6% | 92,4% | 92,4% |
| estados aleatorios de Haar: cobertura | 89,8% | 95,1% | 94,9% |
Cerca del polo el método delta cubre el valor verdadero en menos de uno de cada diez experimentos; Wilson y la posterior de Haar recuperan la cobertura nominal. Sobre estados de Haar, la media posterior tiene un error cuadrático 4% menor que la frecuencia cruda.
La Figura 4.2 muestra la causa en mili-qang. Con 50 disparos, el ancho del intervalo del método delta cae a cero en los extremos de la escala: con 50 ceros en 50 disparos da \([+1000,+1000]\) m-qg, un intervalo sin ancho. Con 48 ceros da \([+811,+1029]\) m-qg, que se sale de la escala por arriba. Wilson da \([+731,+978]\) y Bayes–Haar \(+885\) \([+731,+975]\) m-qg: anchos que no colapsan y quedan dentro de \([-1000,+1000]\).
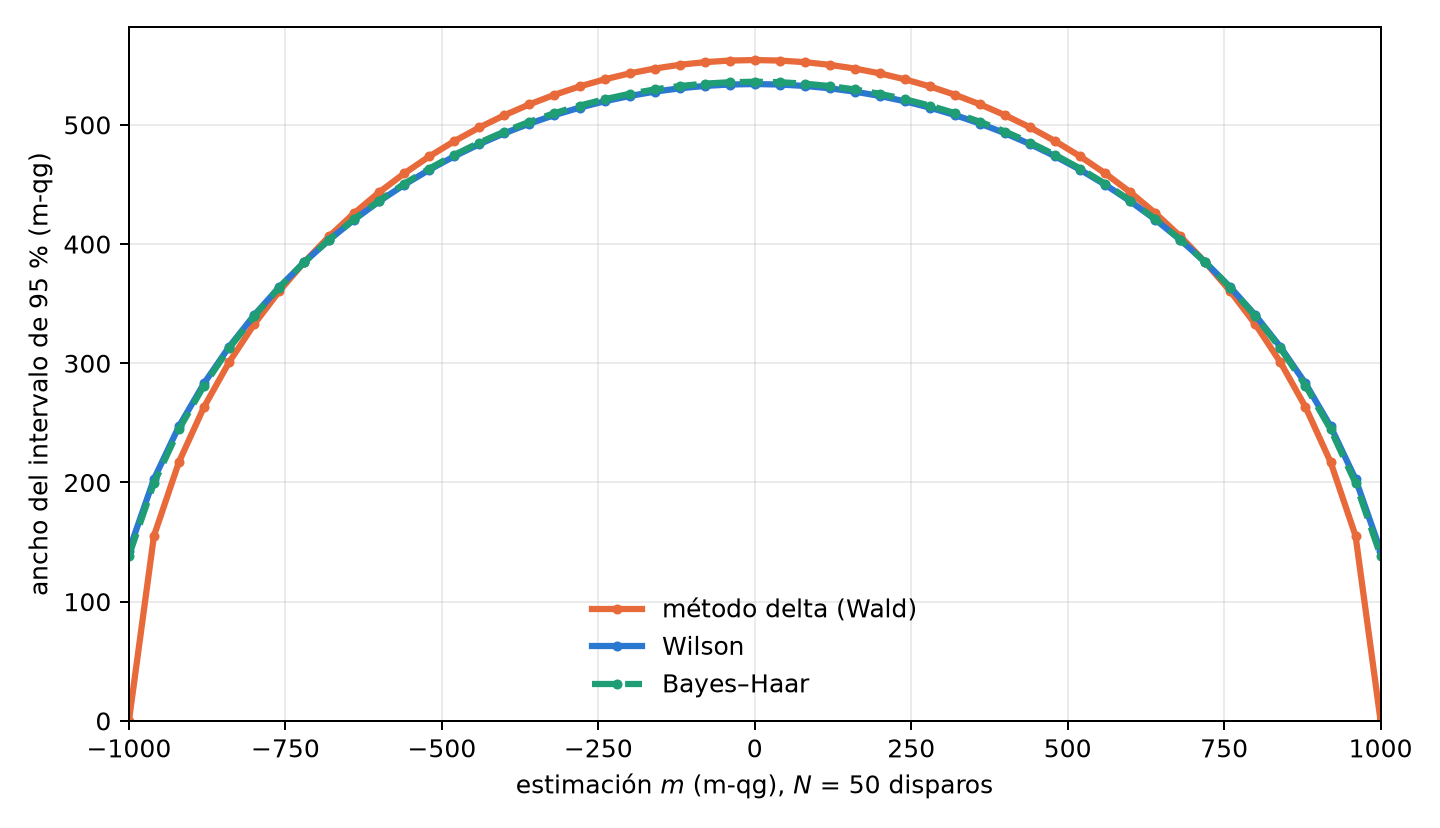
La lectura honesta de la tabla tiene dos partes. La previa de Haar repara el colapso del método delta y tiene una justificación geométrica limpia; pero el intervalo de Wilson, estándar en estadística, logra la misma cobertura, y la ganancia sobre una buena práctica frecuentista está en la estimación puntual y es modesta. La unidad qg no reduce el número de disparos que exige una precisión dada; lo que aporta es hacer explícito el costo y elegir bien el intervalo.
4.4 Estimadores insesgados de segundo orden
Las cantidades cuadráticas tienen un sesgo sistemático. El estimador directo \(\widehat{qg}^{\,2}\) sobreestima \(qg^2\) en \((1-qg^2)/N\), porque el ruido de disparo siempre suma varianza. La corrección es exacta:
\[ \widehat{qg^2}=\frac{N\,\widehat{qg}^{\,2}-1}{N-1},\qquad \mathbb E\big[\widehat{qg^2}\big]=qg^2 , \]
válida para \(N\ge2\) (qg2_unbiased). Puede dar valores negativos cuando \(qg\approx0\), el precio de ser insesgado. Con \(N=20\) y \(qg=0{,}6\), el estimador directo promedia 0,390 y el corregido 0,358, frente al valor verdadero 0,36.
Importa porque el radio de Bloch del capítulo 5, \(r^2=qg_X^2+qg_Y^2+qg_Z^2\), es una suma de cuadrados: sin la corrección, cada eje suma su sesgo y un estado entrelazado parece más puro de lo que es (§97). La misma corrección interviene en la lectura del corrimiento gravitatorio con dos relojes (§126, capítulo 8).
4.5 Planificar los disparos
La relación inversa, cuántos disparos hacen falta para un error dado, es la que se usa al preparar un experimento. plan_shots convierte un error estándar objetivo del \(qg_Z\) filtrado en disparos y en segundos estimados de procesador, teniendo en cuenta la fracción de disparos que el filtro va a conservar (§143). Para un objetivo de 0,02 (20 m-qg) en dos circuitos por dispositivo planificó 3000–3400 disparos, y en 30 repeticiones el error del peor qubit fue 0,021–0,023 (21–23 m-qg): el plan cumplió. Como referencia, la fórmula del capítulo 1 sin filtro da \(N=(1000\sin\theta/\delta)^2=2500\) disparos para 20 m-qg en el ecuador; el plan pide más porque descuenta los disparos que el filtro va a descartar. La regla simple es \(N_\text{ejecución}=N/(1-P_\text{descarte})\): con un 20 % de descarte, los 2500 disparos útiles piden 3125.
La predicción por qubit, en cambio, resultó 1,4–1,6 veces optimista en promedio, y su análisis es instructivo: los qubits que fallaron eran los cercanos a un polo (\(|qg|>0{,}8\), con cocientes de 2,4–3,1), cuyo \(qg_Z\) el ruido aleja de \(\pm1\) y cuya varianza real es mayor que la ideal. El plan usa el peor qubit y por eso cumple; la opción segura, sin suponer el valor de qg, es planificar para el caso peor, \(qg=0\). La versión de trabajo del autor atribuye ese exceso a la curvatura \(\kappa_{qg}=1000\,\lvert qg_Z\rvert\) del capítulo 1, máxima en los polos: un error aleatorio de pulso corre la lectura hacia el ecuador en proporción a \(\kappa_{qg}\), y ahí la varianza binomial es mayor. Es una interpretación coherente con el capítulo 1, pero no se probó sobre los datos de §143.
4.6 Tomografía con pocos disparos y sombras clásicas
El vector de Bloch completo es \((qg_X,qg_Y,qg_Z)\), uno por eje de medición. Con 10 disparos por eje se compararon seis estimadores sobre 2000 estados (§35). La versión qg aplica la previa de Haar eje por eje, \(\hat r_a=(2k_a-N)/(N+2)\), y proyecta sobre la bola:
| conjunto de estados | inversión lineal | inv. + proyección | máx. verosimilitud | qg-Haar | Jeffreys |
|---|---|---|---|---|---|
| puros de Haar | 0,203 | 0,157 | 0,150 | 0,165 | 0,159 |
| mixtos uniformes | 0,247 | 0,211 | 0,210 | 0,185 | 0,196 |
| puros cerca de un polo | 0,199 | 0,159 | 0,109 | 0,163 | 0,159 |
| muy mixtos (\(|r|<0{,}3\)) | 0,298 | 0,293 | 0,293 | 0,208 | 0,245 |
La inversión lineal da estados no físicos en 52–88% de las corridas sobre estados puros. Sobre estados mixtos el estimador qg-Haar es la mejor fórmula cerrada (12–29% por debajo de máxima verosimilitud); sobre estados puros, su contracción hacia el centro es un error, y pierde frente a máxima verosimilitud, hasta 50% cerca de un polo. La previa adecuada depende de qué estados se esperan.
¿Convendría medir con sombras clásicas (mediciones de Pauli aleatorias) en lugar de medir directamente las bases? Para las cantidades que qang usa, no (§62). Con varianzas exactas por disparo sobre estados de 6 qubits, las sombras necesitan 3–41 veces más disparos para el mismo error: 3,0–4,3× para todos los \(qg_Z\), 5,8–8,1× para el testigo de peso medio del registro, 9–12,6× para todos los correladores \(ZZ\) y 41× para el desbalance filtrado. Solo igualan a la medición directa cuando el objetivo son todas las cantidades de uno y dos qubits a la vez. Y el filtro por disparo no existe con sombras: solo \(3^{-6}=0{,}14\%\) de los disparos aleatorios tienen todos los qubits medidos en \(Z\).
4.7 El fundamento: Riesz–Fréchet
Queda una pregunta conceptual: ¿por qué \(qg_Z\) y no otra función de las poblaciones? Los operadores de un registro de \(n\) qubits forman un espacio de Hilbert de dimensión finita con el producto de Hilbert–Schmidt \(\langle A,B\rangle=\operatorname{Tr}(A^\dagger B)\), y las matrices densidad viven en él. El teorema de representación de Riesz–Fréchet dice que todo funcional lineal continuo \(f\) sobre un espacio de Hilbert tiene la forma \(f(x)=\langle y_f,x\rangle\) para un único \(y_f\); en dimensión finita la continuidad es automática y el teorema se reduce a álgebra lineal (apéndice F).
La aplicación es inmediata. \(\rho\mapsto qg_Z(\rho)=\operatorname{Tr}(\rho\,\sigma_z)\) es lineal en \(\rho\), así que tiene un único representante, \(\sigma_z\). Toda lectura lineal de un estado (un valor esperado, una población, un promedio por disparo) es de esa forma, y \(qg_Z\) es aquella cuyo representante es el observable \(Z\). En cambio \(qg_S(\rho)=H(\langle0|\rho|0\rangle)\) es estrictamente cóncava en \(\rho\): no hay operador que la represente. De ese hecho estructural se siguen dos propiedades ya vistas: los funcionales lineales tienen estimadores insesgados por promedio muestral y la entropía no (desigualdad de Jensen), y la identidad \(qg_S=H((1+qg_Z)/2)\) muestra que \(qg_S\) no contiene información sobre el estado que el representante de \(qg_Z\) no extraiga ya.
El mili-qang hereda esta propiedad: \(m(\rho)=1000\,\operatorname{Tr}(\rho\,\sigma_z)\) también es lineal, con representante \(1000\,\sigma_z\), y por eso su estimador es el promedio de los disparos, sin sesgo. Es la razón de fondo por la que el capítulo 1 definió la unidad sobre la probabilidad y no sobre el ángulo: \(\theta=\arccos(qg_Z)\) no es lineal en \(\rho\), no tiene representante y su estimador directo tiene sesgo. Lo mismo vale para el ángulo en la escala qga del capítulo 1: es el mismo \(\theta\) multiplicado por \(1000/2\pi\), de modo que la escala angular cambia la unidad del ángulo pero no lo vuelve lineal en \(\rho\).
Propuestas abiertas. La versión de trabajo del autor agrega a este capítulo tres propuestas que el libro registra sin verificar: vigilar la información de Fisher \(qg_F=4000\,\operatorname{Var}(\sigma_z)\) para que un ansatz no se acerque a un 2-diseño de Haar global (que la medida de Haar sobre todo \(SU(2^n)\) produce mesetas estériles es un resultado conocido (McClean et al. 2018); que \(qg_F\) sirva para vigilarlo, no); fórmulas de propagación del ruido de disparo para la energía regularizada y la función de radiación del capítulo 1, que dependen de penalizaciones todavía sin definir; y que el gradiente natural en qg diagonalice de forma canónica el tensor de Fubini–Study, que sólo es cierto para las coordenadas \((\theta,\varphi)\) de un qubit (Sección 1.4).
4.8 Las magnitudes derivadas en el muestreo
La formulación del tratado lleva al muestreo las magnitudes derivadas del capítulo 1 (Sección 1.11). Todas se estiman desde los mismos conteos, y cada una hereda una propiedad estadística de este capítulo.
Dos informaciones de Fisher. Un disparo lleva sobre el sesgo polar la información \(F_{qg}=1/(1-qg_Z^2)\), que diverge en los polos, y sobre el ángulo qang \(F_\theta=1\), constante. Son la misma información en dos coordenadas, y la curvatura de información es la primera en bits: \(qg_\kappa=F_{qg}/\ln2\).
Señal a ruido y curvatura con todos los disparos iguales. Los estimadores directos de \(qg_{SNR}\) y \(qg_\kappa\) dividen por \(1-\widehat{qg}_Z^{\,2}\) y se vuelven infinitos cuando los \(N\) disparos coinciden, que es justamente el caso de la Sección 4.3. La media posterior de Bayes–Haar los mantiene finitos: con 50 de 50, \(qg_Z=50/52=0{,}962\), \(qg_{SNR}=3{,}50\) y \(qg_\kappa=19{,}1\).
La distancia geodésica entre dos muestras. Con \(N_1\) y \(N_2\) disparos, cada ángulo qang tiene varianza \(1/N\), de modo que
\[ \widehat{qg}_L=\frac{\lvert\hat\theta_1-\hat\theta_2\rvert}{2}, \qquad \operatorname{Var}\big(\widehat{qg}_L\big)\approx\frac14\left(\frac1{N_1}+\frac1{N_2}\right), \]
sin depender de dónde estén los dos estados. Es la mitad de la \(h\) de Cohen, el tamaño de efecto clásico para comparar dos proporciones, así que la prueba no es de qang: qang le da el nombre de distancia. Con 750 y 700 ceros en 1000 disparos cada una, \(\widehat{qg}_L=0{,}056\) rad (8,9 qga) con error estándar \(0{,}0224\): una diferencia de 2,5σ. Vale lo dicho en el capítulo 1: en un meridiano común es la distancia de Fubini–Study; con azimutes distintos, una cota inferior.
El déficit disipativo desde conteos. \(qg_\tau=\sqrt{1-r^2}\) es una cantidad cuadrática, y hereda el sesgo de la Sección 4.4 con el signo opuesto. Con \(N\) disparos por eje, el radio directo cumple
\[ \mathbb E\big[\hat r^{\,2}\big]=r^2+\frac{3-r^2}{N}, \]
de modo que el ruido de disparo hace parecer al estado más puro de lo que es. Un estado puro medido con 100 disparos por eje promedia \(\hat r^{\,2}=1{,}02\), fuera de la esfera. Un estado con \(r=0{,}9\) (\(qg_\tau=0{,}436\)) promedia \(\hat r^{\,2}=0{,}832\) con el estimador directo y \(0{,}810\) con el corregido, que es el valor verdadero. La raíz, en cambio, no queda insesgada ni siquiera con la corrección: \(\widehat{qg}_\tau\) promedia \(0{,}376\) con el radio directo y \(0{,}404\) con el corregido, los dos por debajo de \(0{,}436\), porque la raíz es cóncava y se recorta en cero. La formulación propone \(\sqrt{\max(0,1-\hat r^{\,2})}\) como estimador insesgado; el corregido reduce el sesgo a la mitad, no lo elimina.
4.9 Sin qang y con qang
| acción | sin qang | con qang | diferencia |
|---|---|---|---|
| intervalo de confianza cerca de un polo | método delta: cobertura por debajo de 10% | Bayes–Haar, \(\mathrm{Beta}(1,1)\): uniforme en m-qg, cobertura nominal | a favor del método, no sólo de qang: el intervalo de Wilson, sin qang, también la recupera; qang justifica la previa (Haar es uniforme en m-qg) |
| cantidades cuadráticas (radios, \(qg^2\)) | elevar al cuadrado la estimación: sesgo hacia arriba | \((N\widehat{qg}^{\,2}-1)/(N-1)\) | es el estimador insesgado estándar; qang lo empaqueta y lo aplica en todos los capítulos |
| cuántos disparos medir | varianza binomial del estado | \(N=(1000\sin\theta/\delta)^2\) para resolver \(\delta\) m-qg | equivalente; la fórmula en m-qg es la que se usa para planificar |
| comparar dos lecturas | \(h\) de Cohen | \(qg_L=h/2\), con varianza \(\tfrac14(1/N_1+1/N_2)\) en todo el círculo | ninguna: es la misma prueba, con nombre de distancia |
| estimar la falta de pureza | \(1-\operatorname{Tr}\rho^2\) con tomografía | \(qg_\tau\) con cuadrados insesgados | el sesgo de \(\hat r^{\,2}\) desaparece; el de \(\widehat{qg}_\tau\) baja a la mitad, no se elimina |
| medir cantidades qang | sombras clásicas | medición directa en \(Z\) | 3–41 veces menos disparos, pero es una elección de medición, no un efecto de la unidad |
| justificar la lectura | — | Riesz–Fréchet: \(qg_Z\) es la lectura lineal canónica | a favor: explica por qué se promedia \(qg_Z\) y no el ángulo |
Balance. La estadística del capítulo es estadística clásica de proporciones. qang aporta la elección de coordenada (uniforme bajo Haar, lineal por Riesz–Fréchet) que dice qué previa usar y qué promediar; la mejora de cobertura existe también sin qang.
4.10 En código
import math
from qang import probability, proportions, statistics

statistics.bayes_qg_estimate(48, 50)     # posterior de Haar: qg_Z 0.885, intervalo [0.731, 0.975]
statistics.wilson_qg_estimate(48, 50)    # la alternativa frecuentista
statistics.qg2_unbiased(16, 20)          # qg^2 sin el sesgo (1 - qg^2)/N
statistics.radius2_estimate([(77, 100), (50, 100), (86, 100)])   # r^2 insesgado y su error, tres ejes
proportions.cohens_h(0.75, 0.70) / 2     # qg_L entre dos lecturas: 0.056 rad

probability.analyze(48, 50).milliqang    # (920.0, 730.8, 977.9) m-qg con el intervalo de Wilson
probability.shots_for_resolution(20, math.pi / 2)   # 2500 disparos para 20 m-qg en el ecuador
4.11 Resumen
- \(\widehat{qg}_Z\) es insesgado y alcanza la cota de Cramér–Rao; el método delta colapsa cerca de los polos, donde su intervalo en m-qg pierde el ancho o se sale de la escala.
- Bajo la medida de Haar, \(qg_Z\) es uniforme en \([-1,1]\), es decir, uniforme en mili-qang y en \(p_0\); la previa correspondiente es \(\mathrm{Beta}(1,1)\) y da intervalos exactos con una función beta.
- Wilson y Bayes–Haar recuperan la cobertura nominal donde el método delta cubre menos de 10%; ninguno reduce los disparos necesarios.
- Las cantidades cuadráticas necesitan la corrección \((N\widehat{qg}^{\,2}-1)/(N-1)\); sin ella, los radios de Bloch se sobreestiman.
- De las magnitudes derivadas, \(qg_L\) entre dos muestras es la mitad de la \(h\) de Cohen, con varianza \(\tfrac14(1/N_1+1/N_2)\); \(qg_\tau\) estimado de conteos queda sesgado hacia abajo aun con la corrección cuadrática.
- Planificar con el peor qubit cumple el objetivo; los qubits cerca de un polo son los que el ruido más aleja.
- Para las cantidades de qang, medir directamente en \(Z\) cuesta 3–41 veces menos disparos que las sombras clásicas.
- \(qg_Z\), y con él el mili-qang, es la lectura lineal canónica por el teorema de Riesz–Fréchet; \(qg_S\) y el ángulo no son lineales y no tienen representante.
Notas bibliográficas
La cota de Cramér–Rao está en Cramér (1946) y Rao (1945), y la previa invariante, en Jeffreys (1946). El intervalo de puntaje es Wilson (1927). Para muestrear la medida de Haar, véase Mezzadri (2006); las sombras clásicas son Huang et al. (2020). El teorema de representación de Riesz–Fréchet es Riesz (1907) y Fréchet (1907). Las notas de investigación numeradas (§) que cita el capítulo y los scripts que lo verifican están en el repositorio (Monteverde 2026a); la definición de la unidad qang, en Monteverde (2026b).