28 Metodología: el protocolo de falsación pre-registrada
Los capítulos anteriores citaron una y otra vez “predicciones registradas antes de correr”. Este capítulo explica qué quiere decir eso, cuántas se cumplieron y cuántas fallaron, y algo que un libro sobre una escala nueva le debe a quien lo lee: una auditoría de si esa anterioridad se puede comprobar. No hay física nueva acá. El script del capítulo no simula nada: revisa el propio repositorio, su historia de git y los archivos que guardaron las corridas.
28.1 Desde la base: una predicción es una lectura que se puede equivocar
En la escala del capítulo 1, casi toda afirmación de las notas es un número en m-qg o una razón entre dos errores. Que el filtro “ayude” no dice nada; que baje el error de la lectura de 104 a 23 m-qg en tres dispositivos sí, y puede fallar. La disciplina es escribir ese número y el umbral que lo haría falso antes de correr, dejarlo fijado de una forma que no se pueda cambiar después, y publicar el resultado cualquiera que sea.
28.2 Dos maneras de fijar una predicción
Las notas usaron dos:
- Por commit: las predicciones se escriben y se suben al repositorio antes de la corrida, y la sección cita ese commit (por ejemplo, “committed before the run (77700bd)”). Es el método de §71 a §165.
- Por sha256: el script que hace la corrida se congela, se calcula el sha256 de sus bytes y se guarda en
examples/data/*.preregcon una fecha. Si el script cambia, el hash deja de coincidir. Es el método de las secciones de neutrinos, núcleos, VarQTE, IQM y otras.
28.3 Balance de aciertos y fallos
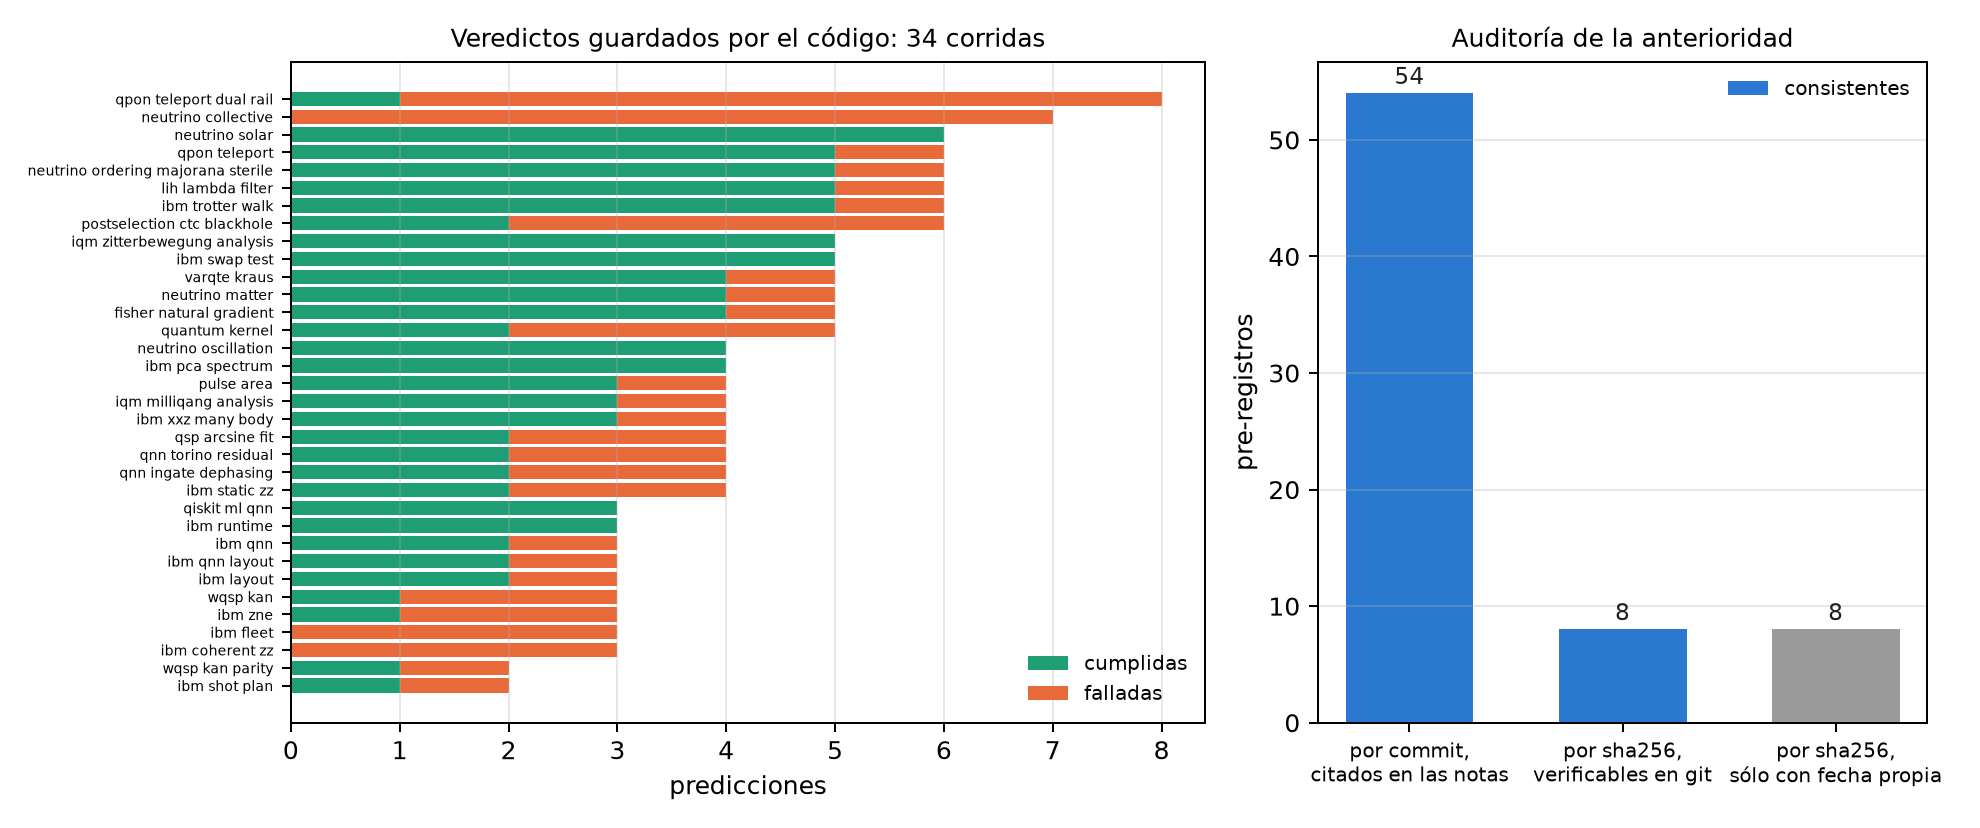
Lo que el código guardó. 34 corridas dejan en su archivo de resultados un diccionario de veredictos calculados por el propio script. El script del capítulo los cuenta: 148 predicciones, 94 cumplidas (64 %) y 54 falladas. Tres corridas fallaron todas sus predicciones (la flota de IBM, el ZZ coherente y los neutrinos colectivos) y siete las cumplieron todas, entre ellas la de \(E=mc^2\) en IQM Garnet (§170).
La línea de QML. Para §75–§123, el README del repositorio lleva otro recuento: 176 predicciones juzgadas, 123 cumplidas y 53 falladas, con 4 más esperando la corrida en hardware de IonQ. Las dos cuentas son contabilidades distintas que se superponen en parte, y no deben sumarse.
Lo que no se puede recontar automáticamente. Las secciones anteriores a §71 casi no usan pre-registro, y muchas posteriores registran sus veredictos sólo en prosa (“Four passed; V1 failed”), con redacciones distintas. Un recuento total sobre §1–§170 haría falta hacerlo a mano, sección por sección. Este libro no lo hace: da las dos cuentas que se pueden comprobar.
Un 64 % de aciertos no es una debilidad. Una tasa cerca del 100 % sería la señal de umbrales demasiado blandos. Varias fallas fueron los resultados más informativos de las notas: el ZZ coherente que el filtro sí ve (capítulo 27), la regla de borrado que hubo que corregir con \((1-h)\) (capítulo 26), la métrica qg_YY que ayuda menos de lo previsto (capítulo 23).
28.4 Auditoría de la anterioridad
Que una predicción se haya escrito “antes” hay que poder comprobarlo. El script lo hace con git:
- Por commit (54 citas, §71–§165): cada commit citado existe en la historia y, en ese commit, las notas todavía no tienen los resultados de la sección. Las 54 son consistentes.
- Por sha256 (16 archivos): ningún script coincide hoy con su hash, lo esperable, porque después de la corrida se le agregan los hallazgos al comentario inicial. La pregunta es si alguna versión guardada coincide.
- En 8 de 16, el hash coincide con el script en el commit que agregó el
.prereg, y ese commit es anterior al de los resultados. La anterioridad está comprobada. - En 8 de 16, el
.preregy los resultados entraron en el mismo commit, y ninguna versión del script guardada en git coincide con el hash: el script se congeló, se corrió y se editó antes de subir nada. Para esos ocho la anterioridad descansa sólo en la fecha que trae el propio archivo, que el autor pudo escribir en cualquier momento.
- En 8 de 16, el hash coincide con el script en el commit que agregó el
Los ocho son: materia y oscilación de neutrinos, ordenamiento y estériles, neutrinos solares, post-selección y CTC, área de pulso, el núcleo cuántico y VarQTE. Sus resultados no son falsos por esto; su pre-registro no es verificable por terceros. La corrección para lo que venga es simple: subir el .prereg y el script congelado en un commit propio antes de correr.
28.5 Bancos de prueba
Casi todos los resultados del libro son de simulaciones con modelos de ruido calibrados, no de hardware:
- IBM: los modelos de qiskit-ibm-runtime con calibraciones reales publicadas (Brisbane, Sherbrooke, Torino, Fez y una flota de 21), corridos localmente en Aer o en el modo local de IBM Runtime (§137, §144).
- IonQ: el simulador en la nube con los modelos de ruido de Aria-1 y Forte-1, gratis (§20, §38). Sin T1 dominante: la lectura media no se mueve (+0,004 y +0,007, compatibles con cero), al revés que el modelo de IBM.
- IQM: los modelos simulados de Apollo y Garnet, usados como ensayo gratuito antes de cada corrida real.
Un modelo de ruido calibrado no es un dispositivo: no tiene población térmica (capítulo 27), ni deriva, ni la forma en que el software del proveedor agrupa los circuitos. Por eso el libro llama “simulado” a todo lo que no corrió en hardware.
28.6 Hardware real
- IonQ Forte-1 (§128): las predicciones para H\(_2\) con el filtro quedaron fijadas por commit y el ensayo en el simulador las cumplió, pero el proveedor rechazó el primer envío antes de aceptar el trabajo (el proyecto no tenía ese QPU habilitado). No se cobró nada y no hay datos.
- IQM Garnet, neutrinos de 3 sabores (§165, 8 circuitos de 300 disparos): el script recalcula las cuatro comprobaciones desde la corrida guardada, y las cuatro se cumplen. El error baja de 0,0615 a 0,0386 (1,59 veces) y se conserva el 88 % de los disparos. Con el filtro el mínimo de supervivencia queda en 2,6 GeV (exacto 2,63); sin él, en 0,8 GeV.
- IQM Garnet, el milli-qang (§168, 26 circuitos de 4000 disparos en un qubit): tres de cuatro predicciones cumplidas. El script recalcula el costo de la compuerta X con una sola pendiente: 1,64 m-qg por compuerta (\(\chi^2/\text{gl}=0{,}81\)). La predicción M2 falló: las diez copias del ecuador se dispersan la mitad de lo que permite el ruido binomial (cociente 0,50). Queda abierta.
- IQM Garnet, \(E=mc^2\) como lectura (§170, 24 circuitos de 2000 disparos en el mismo qubit): el pre-registro se subió al repositorio en su propio commit antes del trabajo, como pedía la corrección de Sección 28.4, y por eso es el octavo sha256 comprobable. Las cinco predicciones se cumplen (Sección G.6), con un sesgo de compuerta de 26 a 71 m-qg que queda a la vista.
Las tres corridas de IQM son el primer dato en hardware real del proyecto, y el capítulo 31 las trata en detalle. Hay una réplica de §168 preparada en cinco qubits y dos días, sin subir al repositorio, porque a tamaño completo costaría unos 80 créditos, y después de §170 quedan unos 5 (estimado).
El criterio \(\mathrm{Var}_\theta(F_{\text{eco}})\). El índice anunciaba un criterio de falsación para QPU basado en la varianza del eco de inversión sobre trayectorias continuas. No está definido en ninguna parte del repositorio, así que el libro no lo usa. Queda como propuesta sin escribir.
28.7 Sin qang y con qang
Este capítulo no compara la escala qang contra otra cosa: compara trabajar sin pre-registro contra trabajar con él.
| acción | sin pre-registro | con pre-registro | diferencia |
|---|---|---|---|
| decidir si un resultado ayuda | se decide al ver los datos | umbral fijado antes, en m-qg o en razones | a favor: 54 de 148 predicciones fallaron y quedaron publicadas |
| informar las fallas | se omiten o se reinterpretan | se informan con su número (94/54, 123/53) | a favor |
| comprobar la anterioridad | imposible | por commit: 54 de 54 comprobadas; por sha256: 8 de 16 | a favor, con 8 casos sin verificar |
| ensayar antes de gastar | — | simulador gratuito con las mismas predicciones antes de cada QPU | a favor: el rechazo de IonQ no costó nada |
| fijar el script por sha256 | — | sólo verificable si el .prereg se sube antes de los resultados |
ninguna en 8 casos: hay que corregir el procedimiento |
Balance. El pre-registro funcionó: dejó fallas a la vista y se pudo comprobar en 61 de 69 casos. Los 8 restantes muestran un defecto del procedimiento, no del resultado, y ya tienen solución. La lección vale para todo el libro: una cifra sin su umbral previo no es evidencia, y un umbral previo que no se puede comprobar tampoco del todo.
28.8 En código
import hashlib, subprocess

h, path = open("examples/data/iqm_neutrino_qg.prereg").read().split()[:2]
c = "a74c07c5"                                     # commit que agregó el .prereg
frozen = subprocess.run(["git", "show", f"{c}:{path}"], capture_output=True).stdout
hashlib.sha256(frozen.replace(b"\r\n", b"\n")).hexdigest() == h   # True: el script congelado es éste
28.9 Resumen
- Las predicciones se fijaron por commit (§71–§165) o por el sha256 del script congelado.
- Las 34 corridas que guardan veredictos suman 148 predicciones: 94 cumplidas y 54 falladas; la línea de QML (§75–§123) lleva 123 y 53. Un recuento total de §1–§170 haría falta hacerlo a mano.
- La anterioridad se comprueba en las 54 predicciones por commit y en 8 de los 16 pre-registros por sha256; en 8 sólo hay una fecha propia.
- Casi todo es simulado con modelos calibrados. El hardware real son tres corridas en IQM Garnet: los neutrinos (4 de 4), el milli-qang (3 de 4, con 1,64 m-qg por compuerta X) y \(E=mc^2\) como lectura (5 de 5, §170).
- El criterio \(\mathrm{Var}_\theta(F_{\text{eco}})\) no existe en el repositorio y no se usa.
Notas bibliográficas
El criterio de falsación es el de Popper (1959), y el pre-registro como práctica, Nosek et al. (2018). Las notas de investigación numeradas (§) que cita el capítulo y los scripts que lo verifican están en el repositorio (Monteverde 2026a); la definición de la unidad qang, en Monteverde (2026b).